一、先明确GR&R研究什么
GR&R(量具重复性与再现性)用于评价测量系统的变差。典型计量型研究将观测值分解为零件差异、人员差异、人员与零件交互作用,以及同一条件下的重复测量误差。
重复性EV关注同一人员、同一设备、同一零件在规定条件下多次测量的离散,影响因素不只设备,还包括定位、夹紧、接触和短期环境。再现性AV关注研究中人员之间的差异;在包含交互项的模型中,还应包括人员与零件交互作用。不同软件可能将这些项目分开列示,核对时必须先统一定义。
GR&R不是偏倚、线性或长期稳定性的替代研究。本文的计算示例针对平衡、完整的两因素交叉随机效应设计,不能原样用于属性判定、嵌套、缺失数据或其他复杂结构。
二、先选试验结构,再选统计方法
| 设计 | 数据结构 | 适用条件与注意事项 |
|---|---|---|
| 交叉设计 | 每名人员测量同一组零件,每个“人员×零件”组合重复测量。 | 零件可重复测量,测量不会显著改变特性;便于分离零件、人员及交互影响。 |
| 嵌套设计 | 各人员测量各自的样品,样品嵌套于人员或其他因素。 | 常见于无法共享同一件的研究。不同样品必须按设计满足必要的同质性假设,否则样品差异会与测量差异混杂。 |
| 扩展设计 | 增加设备、班次、地点等因素,允许交叉、嵌套或混合结构。 | 按风险选择因素,明确随机/固定效应与交互项;采用适合该结构的模型,不能只增加表格列数。 |
破坏性试验不等于“不同人随便测不同零件”。同一件不能重复时,通常需用同批或同质样品设计重复单元,论证样品间变差可否忽略或单独估计。如果没有这些条件,就不能把剩余变差直接称为重复性。
三、现场怎样实施
- 定义对象与接受准则
明确特性、单位、规格、用途、设备、量程和客户要求,确定报告采用的变差倍数及百分比口径。
- 选择有代表性的零件与人员
零件覆盖实际或预期过程变差,人员来自真实使用岗位;不能故意扩大零件差异来“美化”GRR百分比。
- 确认研究前提
检查分辨力、校准状态、参考件、环境及零件稳定性;统一已批准的方法,不在试验中临时调整补偿值。
- 确定数量与测量顺序
“10件×3人×3次”是常见方案,并非所有场景的强制配置。数量应满足适用要求和研究目的,各轮对零件顺序随机化。
- 按日常方法独立测量
每次重新取放、定位或夹紧,模拟真实操作;不让人员参考前次或他人读数,避免只连续读数而未重复整个测量过程。
- 保存原始数据与现场事件
记录零件、人员、次数、顺序、读数及异常。保留足够小数位,不先取平均、不补齐“理想数据”,也不随意删除离群值。
- 分析、整改并复验
先审查图形、异常与模型,再解释指标,记录结论的适用范围、责任人和复验条件。
四、均值极差法和ANOVA怎样选
| 方法 | 主要做法 | 适用边界 |
|---|---|---|
| 均值极差法 | 由单元极差、人员均值极差及零件均值极差,配合对应系数估计EV、AV和PV。 | 适合规定结构下的基础研究与手算核对;不能像含交互项的ANOVA那样单独估计人员×零件交互。 |
| ANOVA法 | 按统计模型分解平方和与方差分量,可研究人员、零件及交互作用。 | 需正确设定模型及前提;不是使用ANOVA就自动更可靠。复杂结构与缺失数据应采用相应方法。 |
Excel并不天然等于均值极差法,软件也不天然等于ANOVA。应核对所用模板或程序的模型、系数、交互处理与报告口径。
五、均值极差法的计算逻辑
设有p个零件、o名人员、每个组合重复r次。本文将EV、AV、PV、GRR和TV统一定义为1σ标准差量,对应的平方才是方差;若模板输出5.15σ或6σ研究变差,不能与1σ系数混用。
- 平均极差R̄:先对每个“人员×零件”的r次读数求最大值减最小值,再对全部po个极差取平均。
- 人员均值极差RO:每名人员的全部pr个读数先求均值,再取这些人员均值的最大值减最小值。
- 零件均值极差RP:每件零件的全部or个读数先求均值,再对零件均值取极差。
EV = K₁ × R̄
AV = √max{0, (K₂ × RO)² − EV² / (p × r)}
PV = K₃ × RP
GRR = √(EV² + AV²);TV = √(GRR² + PV²)
K₁、K₂、K₃必须取自与具体方法、研究规模和变差口径匹配的系数表。K₁主要对应单元内重复次数;K₂对应人员均值极差的估计方式;K₃对应零件均值极差的估计方式。不同表可能已经把变差倍数纳入系数,不能只认“K”的名称。
AV中的扣除项用于修正人员均值内仍含有的重复性影响。出现负的方差估计时,常见约定是截为0,但这不等于真实影响绝对不存在,仍需检查研究数量、数据与方法。上述基础式不单独估计交互项;存在明显交互风险时,应采用适用模型。
六、交叉ANOVA怎样分解变差
对完整平衡设计,可写成:读数=总体均值+零件效应+人员效应+人员×零件交互+重复误差。下式用于各效应独立的两因素随机模型。若人员作为固定效应、数据不平衡或因素结构不同,应重新确定模型及结论的外推范围。
记ȳi··为第i件零件的均值,ȳ·j·为第j名人员的均值,ȳij·为该组合均值,ȳ···为总体均值。平方和SS反映相应来源的离散,均方MS=SS/自由度df。
| 来源 | 平方和SS | df |
|---|---|---|
| 零件P | or × Σi(ȳi·· − ȳ···)² | p − 1 |
| 人员O | pr × Σj(ȳ·j· − ȳ···)² | o − 1 |
| 交互PO | r × Σi,j(ȳij· − ȳi·· − ȳ·j· + ȳ···)² | (p − 1)(o − 1) |
| 重复误差E | Σi,j,k(yijk − ȳij·)² | po(r − 1) |
σ²E = MSE
σ²PO = max{0, (MSPO − MSE) / r}
σ²O = max{0, (MSO − MSPO) / (p × r)}
σ²P = max{0, (MSP − MSPO) / (o × r)}
EV² = σ²E;AV² = σ²O + σ²PO
GRR² = EV² + AV²;TV² = GRR² + σ²P
这里把交互项计入再现性。若报告把“人员AV”和“交互INT”分列,合成GRR时应分别计入,不能漏项或重复相加。标准差不能直接相加,必须先加方差,再开平方。
是否合并不显著交互项,应按预先确定的分析规则处理;合并后需重新计算误差均方及相关分量,不能仅把交互方差删除。下面的示例保留完整交互模型。
七、一个可复算的完整示例
示例采用10件零件、3名人员、每人每件测3次,共90条读数;单位mm,规格9.900~10.100,公差T=0.200。全部数据为教学模拟,不是客户或产品性能实测结果。
下载90条原始测量数据(CSV)。表中同时保留测量顺序、零件、人员、轮次及原始读数;复算时不要先对每件数据取平均。
| 人员 | 第1次 | 第2次 | 第3次 |
|---|---|---|---|
| A | 9.9190 | 9.9123 | 9.9222 |
| B | 9.9293 | 9.9153 | 9.9138 |
| C | 9.9210 | 9.9298 | 9.9281 |
将90条数据按上一节公式计算,得到下表。SS与MS的单位均为mm²;显示值做了四舍五入,实际计算保留完整精度。
| 来源 | SS | df | MS |
|---|---|---|---|
| 零件 | 0.232982951 | 9 | 0.025886995 |
| 人员 | 0.001875090 | 2 | 0.000937545 |
| 人员×零件 | 0.001425868 | 18 | 0.000079215 |
| 重复误差 | 0.001816520 | 60 | 0.000030275 |
例如,σ²PO=(0.000079215−0.000030275)/3≈0.000016313;σ²O=(0.000937545−0.000079215)/30≈0.000028611。
| 分量 | 方差(mm²) | 标准差(mm) |
|---|---|---|
| 重复性EV | 0.000030275 | 0.005502 |
| 人员主效应 | 0.000028611 | 0.005349 |
| 人员×零件 | 0.000016313 | 0.004039 |
| 再现性AV(含交互) | 0.000044924 | 0.006703 |
| 测量系统GRR | 0.000075200 | 0.008672 |
| 零件间PV | 0.002867531 | 0.053549 |
| 总体TV | 0.002942731 | 0.054247 |
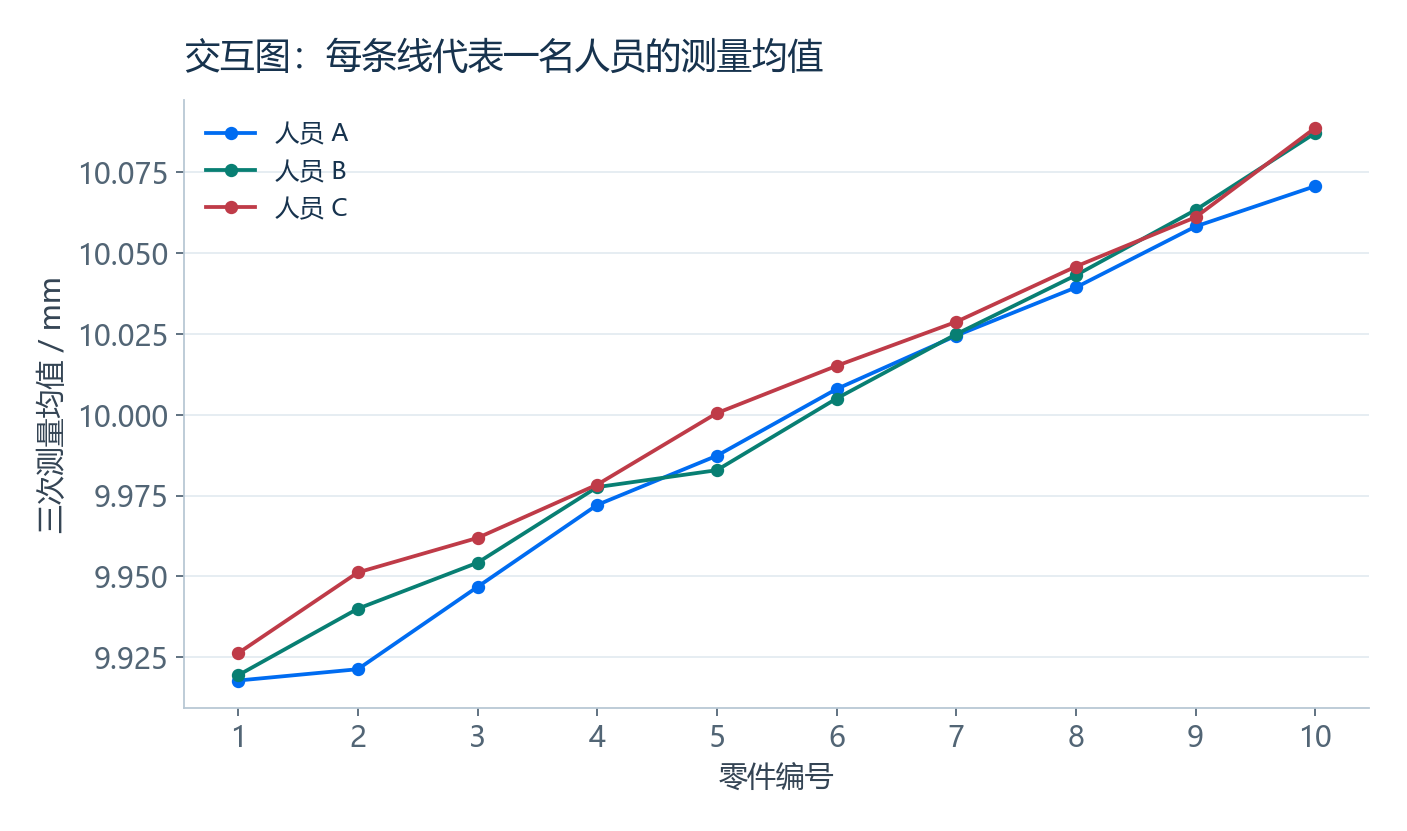
交互项的F=MSPO/MSE≈2.6165,对应p≈0.0028。在常用0.05显著性水平下,本例存在统计显著的交互信号,不能只比较三个人的总体均值。
八、三个“百分比”到底怎么算
| 指标 | 公式 | 本例 |
|---|---|---|
| %Study Var | 100 × GRR / TV | 15.99% |
| %Contribution | 100 × GRR² / TV² | 2.56% |
| %Tolerance(6σ) | 100 × 6 × GRR / (USL − LSL) | 26.02% |
| ndc | 对1.41 × PV / GRR向下取整 | 8 |
%Study Var回答“测量系统标准差占观测总标准差多少”;%Contribution回答“测量系统方差占总方差多少”;%Tolerance回答“选定宽度的测量变差占产品公差多少”。它们不是同一个数,不能相互替代。
本例15.99%与2.56%并不矛盾:当百分数用15.99这样的数值表示时,方差贡献率≈15.99²/100=2.56%。把“2.56%”直接套入“GRR小于10%”的标准差口径,会造成错误放行。
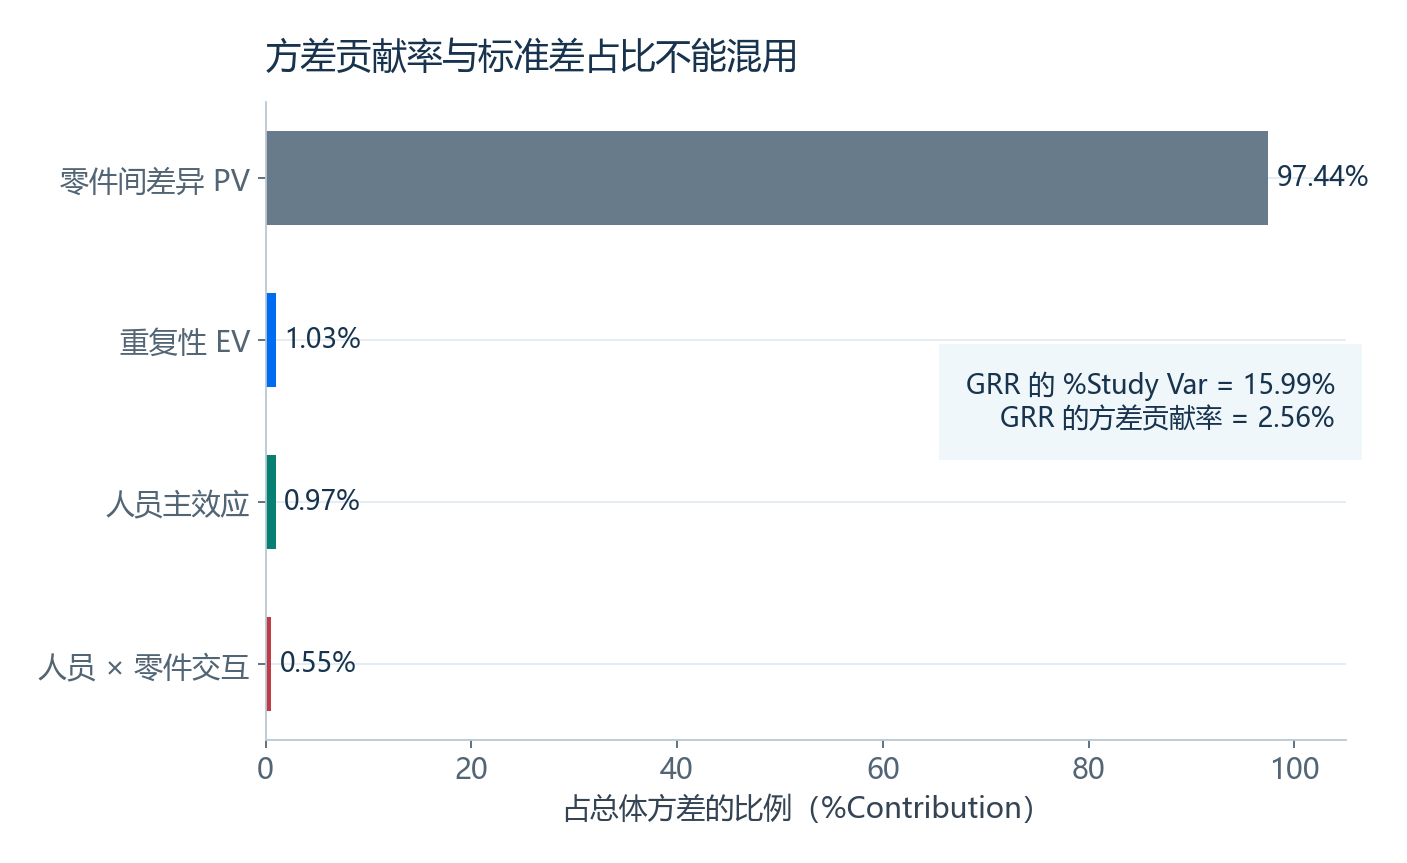
研究变差可按约定采用6σ或5.15σ。若分子分母都乘相同倍数,%Study Var不变;但公差分母不随倍数变化,%Tolerance会改变。因此对照客户模板或软件报告时,应先核对倍数、分母及AV是否含交互,不能只比较最终百分比。
ndc表示测量系统区分零件差异的能力,常见参考目标为至少5类,但应遵循适用要求。它依赖选样范围;人为加入不具代表性的极端件,可能让%Study Var和ndc看起来更好,却并未改善测量系统。
九、怎样给出接受或改进结论
| 标准差口径的比例 | 常见解释 | 应采取的行动 |
|---|---|---|
| <10% | 通常可接受。 | 仍应确认适用范围、参考依据及其他测量风险。 |
| 10%~30% | 可能有条件接受。 | 结合用途、特性风险、替代方案和客户许可,记录条件;不是自动通过。 |
| >30% | 通常需要改进。 | 评估对现有判定的影响,制定整改及复验方案。 |
使用区间前,必须确认适用要求具体针对%Study Var还是%Tolerance,不能将其套用于%Contribution。对于单边规格、特定风险或客户另有要求的场景,应按适用方法评价。
本例%Study Var为15.99%、按6σ计算的%Tolerance为26.02%、ndc为8。不能据此直接写“合格”;应先确认用途与接受准则,调查已识别的人员及交互影响,并说明是否有条件接受、由谁批准,以及需要哪些改进。
十、从结果回到现场改进
- EV偏大:检查分辨力、重复定位、夹紧、接触方式、测量力、零件状态及短期环境,避免只换设备不查方法。
- 人员影响偏大:检查测量基准、操作步骤、读数规则及培训的一致性,不预设一定是人员责任。
- 交互明显:寻找特定几何、表面或尺寸段上人员操作差异,改进夹具与方法后再验证。
- 零件差异过小:核查选样是否反映实际过程,不通过“凑宽范围”美化指标;必要时结合可靠的历史过程信息与公差口径。
- 复验与归档:按预定规则重新研究,保留新旧方案、原始数据、计算设置、图表、结论及批准记录。
对嵌套或扩展设计,还应核对模型是否能真正区分相关来源;试验结构导致的混杂,不能靠增加小数位或更换软件解决。
十一、质创聿景软件的优势
质创聿景质量检验系统提供MSA研究与分析界面,可呈现GRR、ndc、变异分量及ANOVA表,并支持Excel/PDF导出,便于复核计算依据、整理报告和保留研究记录。与量具台账、检验规范、SPC及异常管理集中使用,有助于减少多套表格之间的数据搬运和口径不一致。
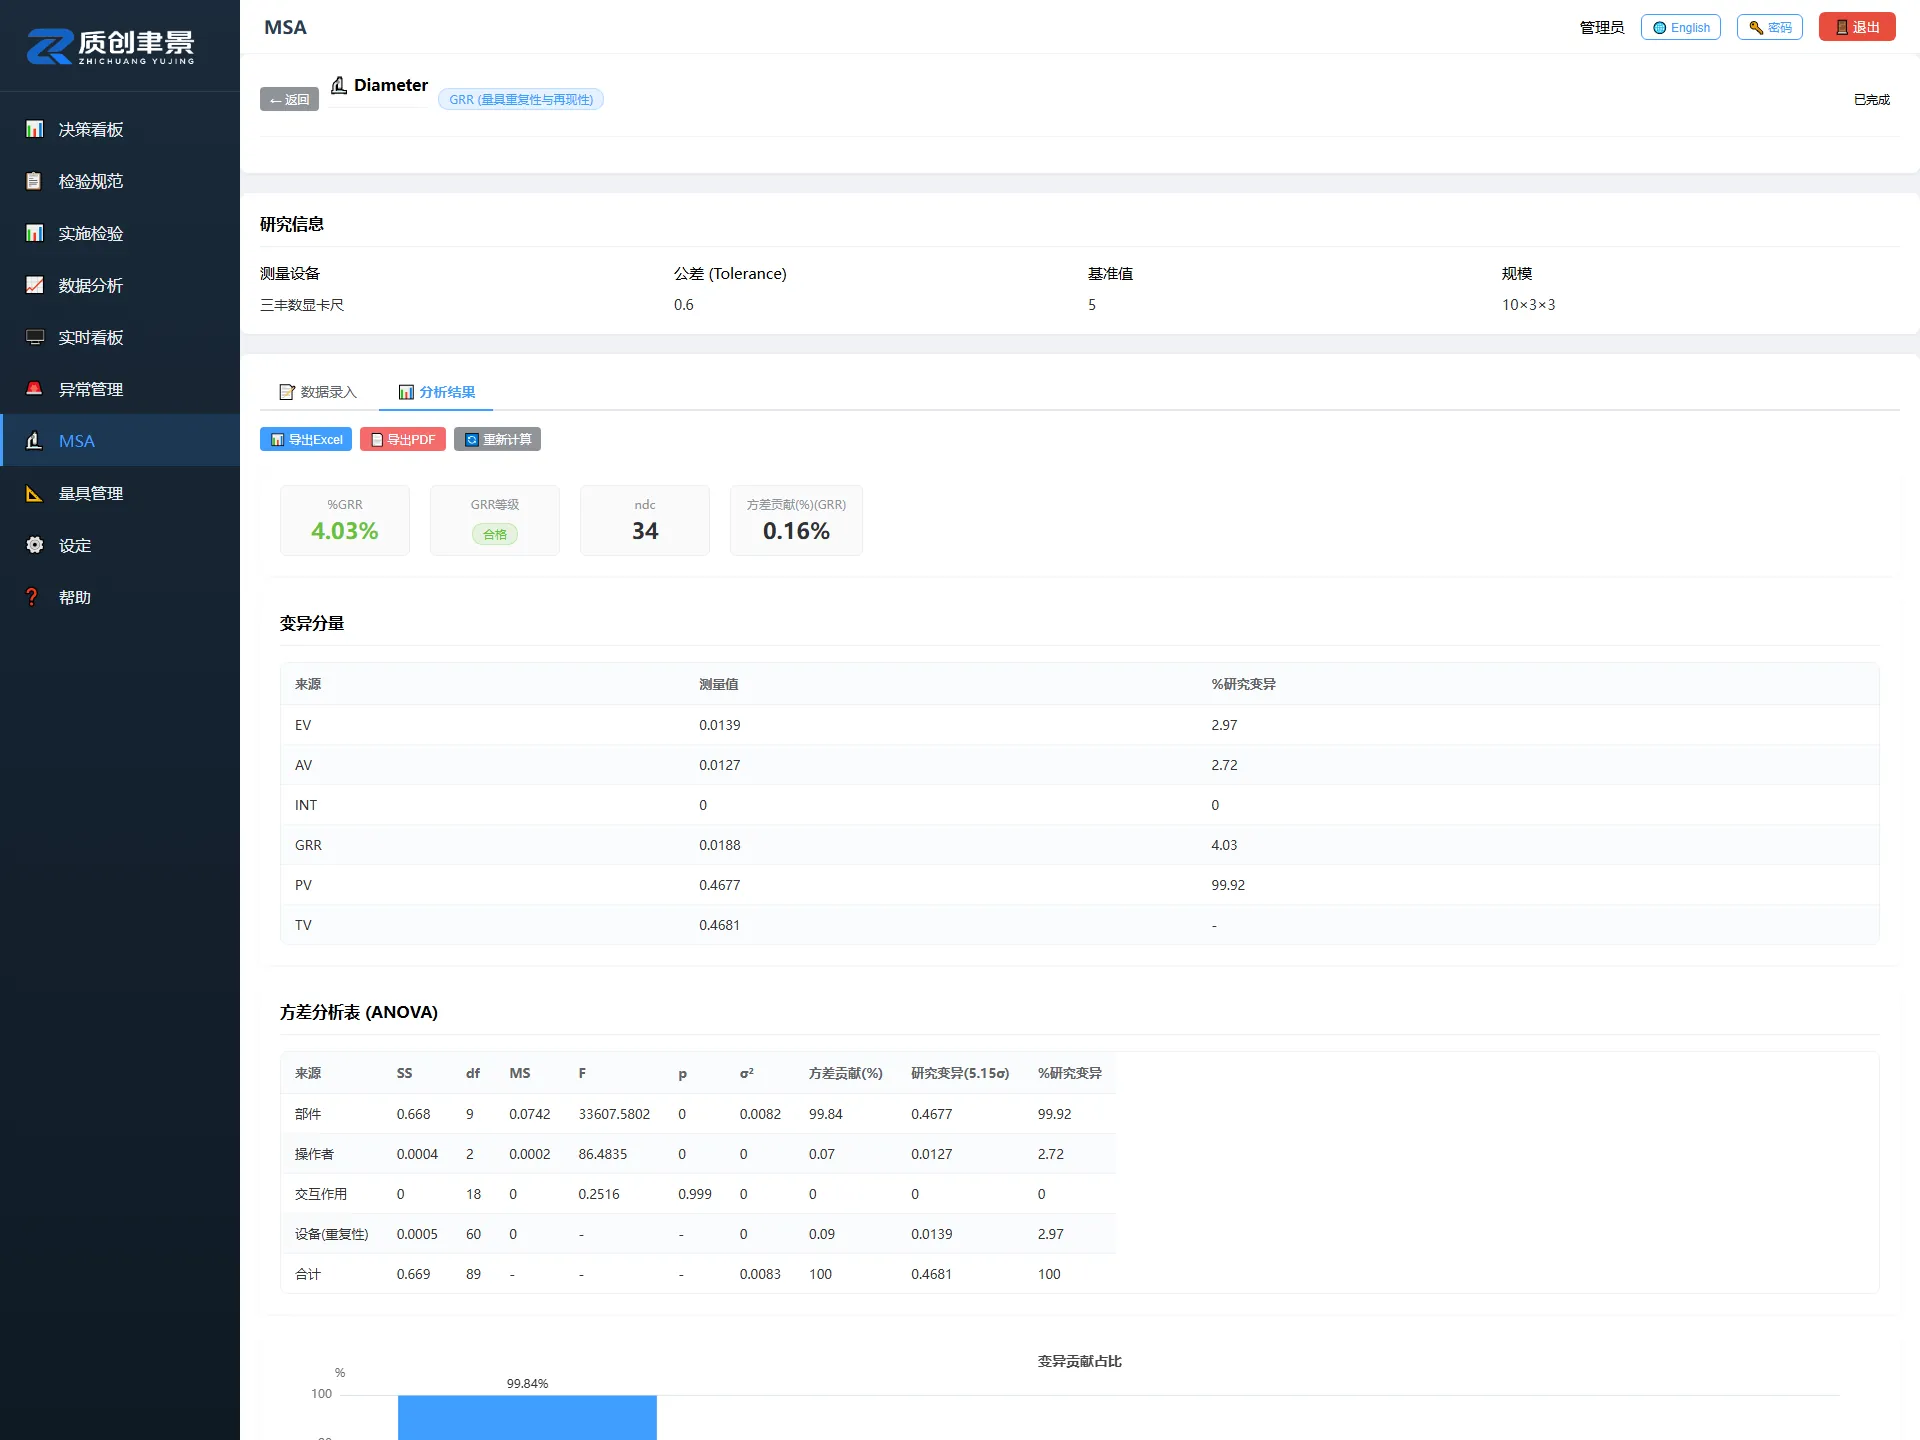
系统支持厂内部署,数据留存在企业环境,便于跨批次复查与追溯。选择交叉、嵌套或扩展模型时,仍应先确认实际软件版本支持的结构;软件不能替代试验设计、方法确认与专业批准。欢迎查看质量检验系统或联系质创聿景申请试用。
参考资料与说明
- NIST:量具R&R研究
- NIST:测量过程表征
- 接受准则、研究规模、系数表与模型设置,以适用客户要求及所采用方法的有效版本为准。本文算例采用完整交互模型、方差分量非负截断及1σ标准差定义,%Tolerance按6σ计算。